
El despliegue de redes neuronales convolucionales (CNNs) profundas como VGG16 o Inception en dispositivos móviles y sistemas embebidos presenta un cuello de botella crítico: el coste computacional y el tamaño del modelo. Mientras que la tendencia académica reciente ha priorizado la precisión absoluta (accuracy) en ImageNet incrementando la profundidad y complejidad, el entorno de producción en edge devices requiere una optimización agresiva de la latencia y el consumo energético.
MobileNet surge como una clase de modelos eficientes diseñados específicamente para estas restricciones. A diferencia de técnicas de compresión a posteriori (como pruning o cuantización), MobileNet optimiza la arquitectura de la red desde su diseño base. La innovación central radica en reemplazar la convolución estándar por Depthwise Separable Convolutions, reduciendo drásticamente la cantidad de parámetros y operaciones de multiplicación-suma (Mult-Adds) con una degradación controlada de la precisión.
Fundamentos matemáticos
La eficiencia de MobileNet se fundamenta en la factorización de la operación de convolución estándar en dos pasos distintos: una convolución espacial por canal (depthwise) y una proyección lineal de canales (pointwise).
Considere una capa de convolución estándar que recibe un tensor de entrada $F$ de dimensiones $D_F \times D_F \times M$ y produce un tensor de salida $G$ de $D_F \times D_F \times N$, donde $M$ son los canales de entrada y $N$ los de salida. Si el kernel espacial es $D_K \times D_K$, el coste computacional $C_{std}$ es:
$$C_{std} = D_K \cdot D_K \cdot M \cdot N \cdot D_F \cdot D_F$$
La Depthwise Separable Convolution divide esto en:
- Depthwise Convolution: Aplica un solo filtro por cada canal de entrada ($M$).
- Pointwise Convolution: Aplica una convolución $1 \times 1$ para combinar linealmente las salidas de la etapa anterior.
El coste de la etapa Depthwise ($C_{depth}$) es:
$$C_{depth} = D_K \cdot D_K \cdot M \cdot D_F \cdot D_F$$
El coste de la etapa Pointwise ($C_{point}$) es:
$$C_{point} = M \cdot N \cdot D_F \cdot D_F$$
El coste total de la convolución separable ($C_{sep}$) es la suma de ambos:
$$C_{sep} = D_K \cdot D_K \cdot M \cdot D_F \cdot D_F + M \cdot N \cdot D_F \cdot D_F$$
Para cuantificar la ganancia, calculamos la relación de reducción comparando ambos costes:
$$\frac{C_{sep}}{C_{std}} = \frac{M \cdot D_F \cdot D_F (D_K^2 + N)}{D_K^2 \cdot M \cdot N \cdot D_F \cdot D_F} = \frac{1}{N} + \frac{1}{D_K^2}$$
Dado que MobileNet utiliza kernels de $3 \times 3$ ($D_K=3$), la reducción computacional es aproximadamente de 8 a 9 veces menor que una convolución estándar, dependiendo del número de canales $N$.
Implementación práctica
La estructura básica de MobileNet no es una simple pila de convoluciones, sino bloques repetidos de Depthwise y Pointwise, cada uno seguido de Batch Normalization (BN) y activación ReLU.
A continuación se presenta una implementación funcional de un bloque separable en Python utilizando una API de alto nivel (tipo Keras) para ilustrar la composición de capas:
def mobile_net_block(inputs, filters, strides=(1, 1)):
    """
    Implementación de un bloque Depthwise Separable Convolution.

    Args:
        inputs: Tensor de entrada.
        filters: Número de filtros para la convolución pointwise (N).
        strides: Paso de la convolución depthwise.
    """

    # 1. Depthwise Convolution
    # Nota: depth_multiplier=1 asegura un filtro por canal de entrada
    x = DepthwiseConv2D(kernel_size=(3, 3),
                        strides=strides,
                        padding='same',
                        use_bias=False)(inputs)
    x = BatchNormalization()(x)
    x = Activation('relu')(x)

    # 2. Pointwise Convolution (1x1 Conv)
    # Proyecta los canales depthwise al nuevo espacio de dimensiones 'filters'
    x = Conv2D(filters=filters,
               kernel_size=(1, 1),
               strides=(1, 1),
               padding='same',
               use_bias=False)(x)
    x = BatchNormalization()(x)
    x = Activation('relu')(x)

    return x
La siguiente figura muestra la estructura interna de un bloque Depthwise Separable típico en MobileNet:
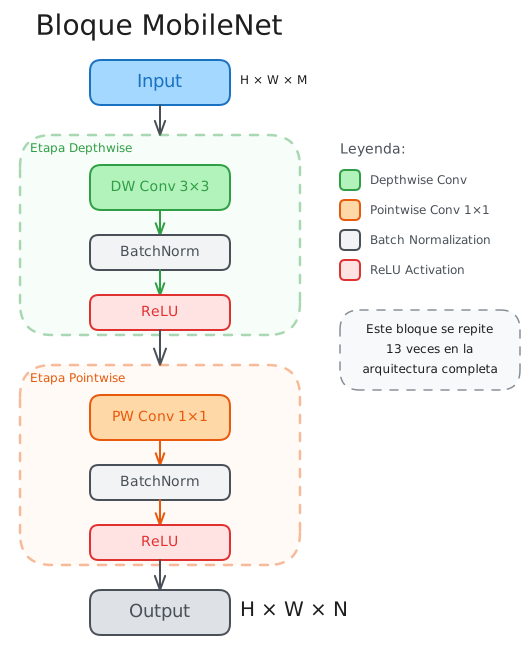
La red completa comienza con una convolución estándar completa, seguida de 13 bloques de convoluciones separables, finalizando con un Average Pooling global y una capa Fully Connected (o convolución 1x1 equivalente) para la clasificación.
Análisis de comportamiento
Al evaluar el comportamiento de MobileNet en entornos de inferencia controlados, se observan las siguientes características:
- Intensidad Aritmética: La reducción de FLOPs es masiva, pero esto traslada el cuello de botella desde la computación hacia el ancho de banda de memoria (memory bandwidth bound) en ciertas GPU, debido a que las convoluciones $1 \times 1$ tienen una baja reutilización de datos en comparación con las $3 \times 3$ densas.
- Hiperparámetros $\alpha$ y $\rho$: MobileNet introduce dos multiplicadores globales para ajustar el coste:
- Width Multiplier ($\alpha$): Reduce uniformemente el número de canales ($M$ y $N$) en cada capa. El coste computacional se reduce cuadráticamente: $C \propto \alpha^2$.
- Resolution Multiplier ($\rho$): Reduce la resolución de entrada. El coste se reduce cuadráticamente: $C \propto \rho^2$.
- Convergencia: El uso extensivo de Batch Normalization es obligatorio. Sin BN, la red tiene dificultades para entrenar debido a la falta de parámetros en la componente depthwise para ajustar la distribución de las activaciones.
Comparativas o referencias técnicas
Comparando MobileNet (1.0) con arquitecturas estándar en el dataset ImageNet (ILSVRC 2012):
| Modelo | Accuracy (Top-1) | Mult-Adds (Millones) | Parámetros (Millones) |
|---|---|---|---|
| VGG16 | 71.5% | 15,300 | 138 |
| GoogleNet | 69.8% | 1,550 | 6.8 |
| MobileNet (1.0) | 70.6% | 569 | 4.2 |
| MobileNet (0.75) | 68.4% | 325 | 2.6 |
Análisis: MobileNet (1.0) alcanza una precisión comparable a VGG16 utilizando aproximadamente 27 veces menos operaciones de punto flotante y un tamaño de modelo 32 veces menor. Comparado con GoogleNet, es más preciso y más eficiente en términos de parámetros y cómputo.
Limitaciones y casos donde no conviene usarlo
A pesar de su eficiencia, MobileNet presenta limitaciones estructurales que deben considerarse antes de su implementación en producción:
- Capacidad de representación reducida: Debido a la factorización, la red tiene menos parámetros para modelar relaciones complejas. En tareas de clasificación de grano muy fino (fine-grained recognition) con datasets masivos y complejos, una ResNet-50 o Inception superará a MobileNet por un margen significativo (3-5% en Top-1 accuracy).
- Entrenamiento desde cero (Training form scratch): MobileNet puede ser más inestable al entrenar desde cero en datasets pequeños comparado con redes sobre-parametrizadas. Se recomienda fuertemente el uso de transfer learning desde pesos de ImageNet.
- Falta de conexiones residuales: En esta primera versión (v1), la ausencia de skip connections limita la profundidad efectiva que la red puede manejar sin sufrir degradación de gradiente, limitando su escalabilidad hacia modelos más profundos.