
Los Large Language Models (LLMs) poseen una memoria paramétrica estática, limitada al conjunto de datos utilizado durante su entrenamiento (cut-off date). Esto genera dos problemas críticos en entornos de producción: la incapacidad de acceder a información privada o reciente y la tendencia a la "alucinación" cuando se fuerza al modelo a inferir sobre dominios desconocidos.
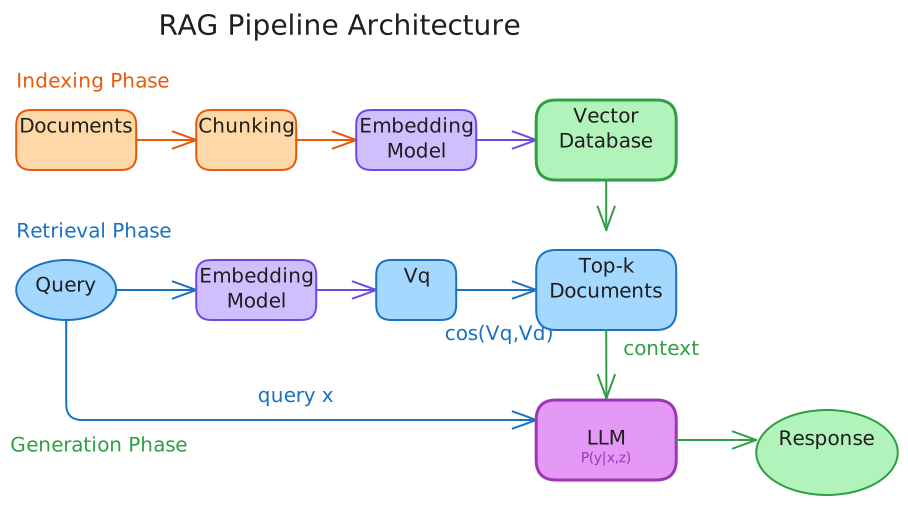
Retrieval-Augmented Generation (RAG) desacopla la capacidad de razonamiento del modelo de su base de conocimiento. En lugar de reentrenar el modelo (Fine-tuning), que es costoso y computacionalmente intensivo, RAG introduce un componente de memoria no paramétrica externa. El flujo de inferencia se altera: antes de la generación, el sistema recupera documentos relevantes ($z$) basados en la consulta de entrada ($x$) y condiciona la respuesta ($y$) en ambos.
Esta arquitectura es el estándar actual para sistemas de búsqueda semántica empresarial, permitiendo trazabilidad de las fuentes y actualización de conocimiento sin modificar los pesos de la red neuronal.
El siguiente diagrama ilustra el pipeline completo de RAG, mostrando las tres fases principales: indexación de documentos, recuperación semántica y generación condicionada.
Fundamentos matemáticos
El objetivo de un modelo de lenguaje estándar es maximizar la probabilidad de la secuencia de salida $y$ dada la entrada $x$: $P(y|x)$.
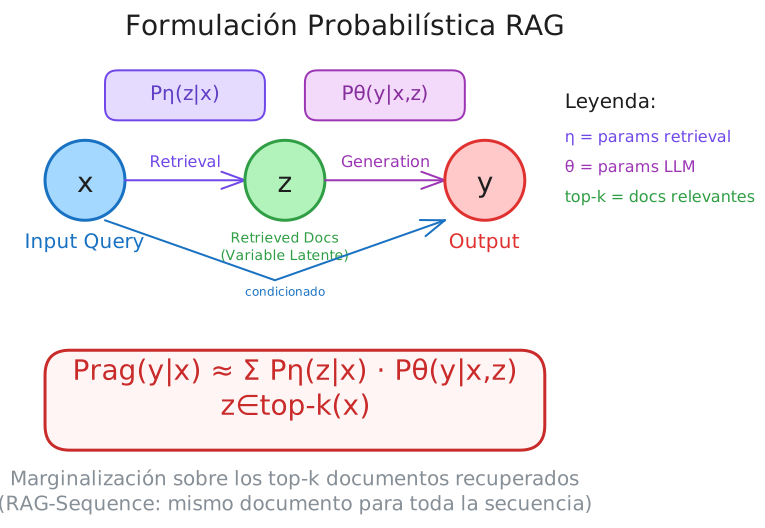
En RAG, introducimos una variable latente $z$ (el documento o fragmento recuperado). La probabilidad de generar la secuencia se marginaliza sobre los documentos recuperados. Formalmente, para un enfoque RAG-Sequence (donde se utiliza el mismo documento para generar toda la secuencia):
$$P_{rag}(y|x) \approx \sum_{z \in \text{top-k}(x)} P_{\eta}(z|x) P_{\theta}(y|x, z)$$
Donde:
- $P_{\eta}(z|x)$ es la probabilidad de recuperar el documento $z$ dado $x$, determinada por el modelo de retrieval (generalmente una métrica de similitud en espacio vectorial).
- $P_{\theta}(y|x, z)$ es la probabilidad generada por el LLM (parametrizado por $\theta$) condicionada tanto por la consulta original como por el documento recuperado.
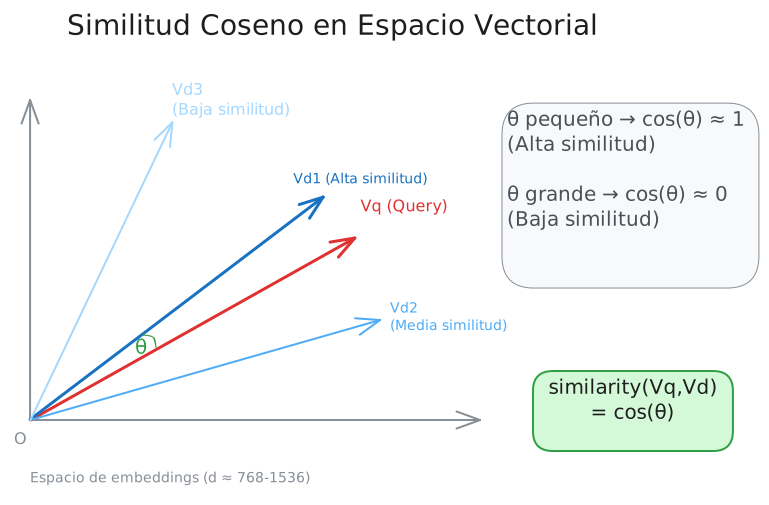
La recuperación se basa en la similitud de cosenos entre el vector de la consulta ($V_q$) y los vectores de los documentos ($V_d$) en un espacio de embeddings denso:
$$\text{similarity}(V_q, V_d) = \frac{V_q \cdot V_d}{\|V_q\| \|V_d\|} = \frac{\sum_{i=1}^{n} V_{q_i} V_{d_i}}{\sqrt{\sum_{i=1}^{n} V_{q_i}^2} \sqrt{\sum_{i=1}^{n} V_{d_i}^2}}$$
El proceso de retrieval busca minimizar la distancia angular en un espacio multidimensional ($d \approx 768$ a $1536$ dimensiones típicamente), asumiendo que la proximidad espacial correlaciona con la relevancia semántica.
La siguiente visualización muestra cómo la similitud coseno determina la relevancia semántica: vectores con menor $ángulo θ$ (mayor $cos(θ)$) representan documentos más similares a la consulta.
Implementación práctica
A continuación, se presenta una implementación mínima funcional en Python que ilustra el ciclo: Chunking $\rightarrow$ Embedding $\rightarrow$ Retrieval $\rightarrow$ Synthesis. Se asume el uso de bibliotecas estándar como numpy y scikit-learn para la operación vectorial, evitando abstracciones de alto nivel para mayor claridad del flujo de datos.
import numpy as np
from sklearn.metrics.pairwise import cosine_similarity
from typing import List, Dict

class SimpleRAG:
    def __init__(self, embedding_fn, llm_fn):
        self.embedding_fn = embedding_fn  # Función que retorna vector (1, N)
        self.llm_fn = llm_fn              # Función que retorna texto
        self.vector_store = []
        self.doc_store = []

    def ingest(self, documents: List[str], chunk_size: int = 500):
        """
        Divide documentos y genera embeddings.
        En producción, esto se persiste en una Vector DB (ej. Pinecone, Milvus).
        """
        for doc in documents:
            # Simulación simple de chunking
            chunks = [doc[i:i+chunk_size] for i in range(0, len(doc), chunk_size)]

            for chunk in chunks:
                vector = self.embedding_fn(chunk)
                self.vector_store.append(vector)
                self.doc_store.append(chunk)

        # Convertir a matriz numpy para búsqueda eficiente
        self.vector_store = np.vstack(self.vector_store)

    def retrieve(self, query: str, k: int = 3) -> List[str]:
        """
        Realiza búsqueda semántica usando similitud de coseno.
        """
        query_vector = self.embedding_fn(query)

        # Cálculo de similitud: (1, dim) x (num_docs, dim)^T
        scores = cosine_similarity(query_vector.reshape(1, -1), self.vector_store)

        # Obtener índices de los top-k resultados
        top_k_indices = np.argsort(scores[0])[::-1][:k]

        return [self.doc_store[i] for i in top_k_indices]

    def generate(self, query: str) -> str:
        """
        Construye el prompt aumentado y genera la respuesta.
        """
        context_docs = self.retrieve(query)
        context_str = "\n---\n".join(context_docs)

        prompt = f"""
        Utiliza el siguiente contexto para responder la pregunta.
        Si no sabes la respuesta, indica que no tienes información.

        Contexto:
        {context_str}

        Pregunta: {query}
        Respuesta:
        """

        return self.llm_fn(prompt)

# Uso hipotético
# rag = SimpleRAG(openai_embedding_func, openai_completion_func)
# rag.ingest(["Datos técnicos sobre el motor X...", "Especificaciones de seguridad..."])
# response = rag.generate("¿Cuál es la temperatura máxima del motor X?")
Análisis de comportamiento
Al desplegar RAG en producción, se observan los siguientes comportamientos críticos:
- Sensibilidad al Chunking: El tamaño del fragmento es un hiperparámetro crucial. Fragmentos muy pequeños pierden contexto semántico (el vector no captura el significado completo). Fragmentos muy grandes introducen ruido, diluyendo la relevancia vectorial y consumiendo la ventana de contexto del LLM innecesariamente.
- Problema de "Lost in the Middle": Los LLMs tienden a prestar más atención a la información al principio y al final del prompt. Si el documento relevante ($z$) se recupera pero queda sepultado en medio de otros documentos menos relevantes dentro del contexto inyectado, el modelo puede fallar en extraer la respuesta ("retrieval success" $\neq$ "generation success").
- Latencia compuesta: El tiempo total de inferencia ($T_{total}$) es la suma de tres componentes secuenciales:
$$T_{total} = T_{embed}(q) + T_{search}(V_q, \mathcal{D}) + T_{gen}(y|x, z)$$
La búsqueda vectorial ($T_{search}$) suele ser muy rápida (milisegundos) gracias a índices como HNSW, pero la generación ($T_{gen}$) aumenta linealmente con la longitud del contexto inyectado.
Comparativas o referencias técnicas
Comparación entre RAG y Fine-Tuning para inyección de conocimiento:
| Característica | RAG (Retrieval-Augmented) | Fine-Tuning |
|---|---|---|
| Actualización de Datos | Inmediata (solo re-indexar). | Lenta (requiere reentrenamiento). |
| Alucinaciones | Bajas (limitado al contexto provisto). | Medias/Altas (el modelo puede "confundir" hechos). |
| Trazabilidad | Alta (se sabe qué documento originó la respuesta). | Nula (conocimiento implícito en pesos). |
| Coste Computacional | Costo de inferencia más alto (prompts largos). | Costo de entrenamiento alto, inferencia estándar. |
| Precisión Sintáctica | Depende del modelo base. | Alta (adapta estilo y formato). |
En benchmarks como MMLU o Natural Questions, RAG supera consistentemente a modelos frozen en preguntas que requieren datos específicos o efímeros, aunque el Fine-Tuning sigue siendo superior para adaptar el estilo de respuesta o aprender lenguajes de dominio específico (DSL).
Limitaciones y casos donde no conviene usarlo
RAG no es una solución universal. Su eficacia se degrada en los siguientes escenarios:
- Razonamiento Multi-hop (Multi-salto): Si la respuesta requiere conectar un hecho en el Documento A con un hecho en el Documento B, y ninguno de los dos documentos responde a la pregunta por sí solo, el retrieval basado en similitud semántica simple suele fallar al no traer ambos documentos simultáneamente.
- Consultas Globales: Preguntas como "¿Cuáles son los temas principales de todos los documentos?" funcionan mal. El enfoque top-k recupera solo una fracción pequeña del corpus, haciendo imposible una síntesis global sin técnicas avanzadas (como Map-Reduce sobre grafos).
- Ambigüedad Semántica: Si la consulta del usuario no comparte vocabulario o semántica directa con los documentos indexados (problema de lexical gap), el sistema de embedding denso puede recuperar falsos positivos con alta confianza pero baja relevancia real.
- Latencia Crítica: Para aplicaciones de voz en tiempo real, la latencia añadida por la recuperación y el procesamiento de contextos extensos puede ser prohibitiva.